
15+芯片覆盖
多元 AI 芯片平台
NVIDIA GPU 及国产 AI芯片等多种异构算力平台


基于 Agent 驱动的算子自动生成、迁移与智能优化能力, 打通模型算子与多元芯片之间的高性能落地链路。
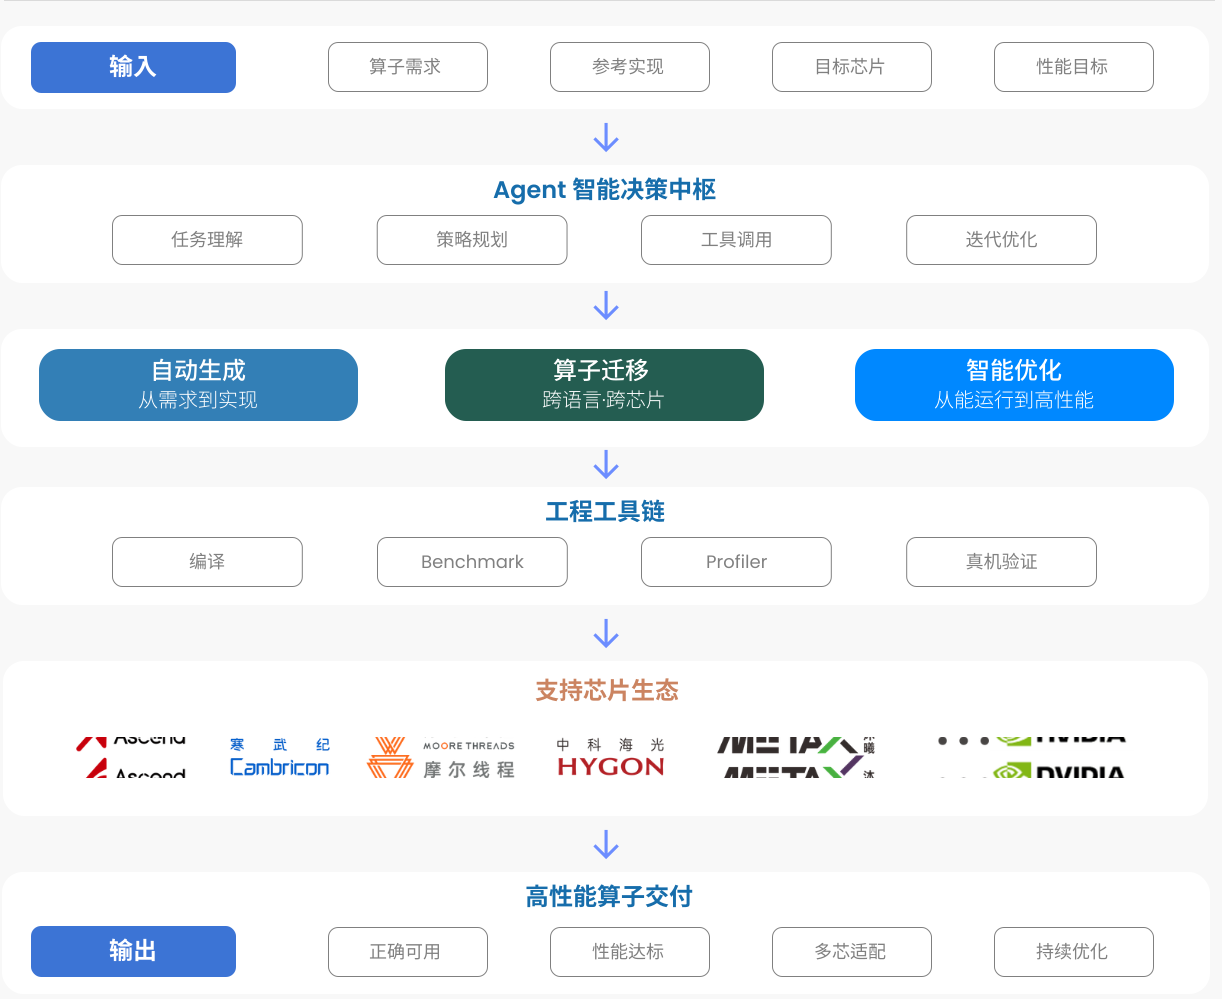
基于 Agent 驱动的算子自动生成、迁移与智能优化能力, 打通模型算子与多元芯片之间的高性能落地链路。
NVIDIA GPU 及国产 AI芯片等多种异构算力平台
Attention、MatMul/GEMM、 Norm、激活、融合算子等
基于真实硬件 Benchmark 测试结果
大幅缩短 典型算子研发周期
以算子为核心,贯通模型、软件与芯片之间的关键性能链路,助力模型加速、算子开发与跨芯适配,全面释放多元算力潜能。
聚焦模型关键算子优化,提升核心计算效率,加速模型整体执行。
覆盖算子生成、编译验证与性能调优,缩短高性能算子开发周期。
支持算子跨芯片快速适配与迁移,降低多元算力环境下的重复开发成本。
针对训练与推理中的热点算子持续优化,提升算力利用率与模型训推效率。
面向多种芯片架构提供统一的算子适配与优化能力,释放不同硬件平台的计算性能。